2026-11-13 · 瀚钦(丹东)智能科技有限公司
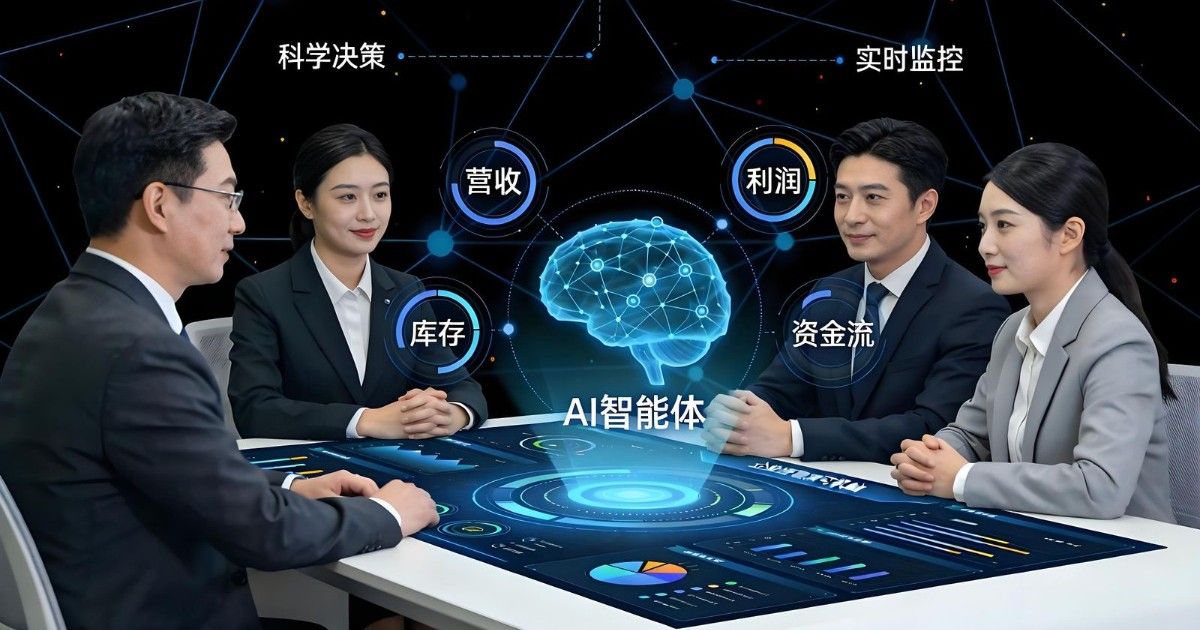
设想一个场景。一家中等规模企业里,财务部和市场部各自养了一个 AI 助手,两个助手共用同一个数据仓库。
财务部的 AI 为了找出高价值客户,把客户隐私表(里面有收入信息)和交易记录表拼在一起查了一遍,算出一个结果:12400 个客户 ID,外加一个汇总数字。这个结果本身没有任何敏感信息——没有身份证号,没有收入数字,看起来干干净净。于是系统很自然地把这个结果存进了共享记忆库。
下一次市场部的 AI 问起「谁是高价值客户」,系统直接把这个缓存结果递了过去。问题是,市场部的 AI 从来没有被授权查看收入数据。这个结果虽然「看起来」安全,但它的计算过程里,确确实实用到了收入这个字段。
这不是一个假设的极客实验,而是当下 AI 智能体(Agent)架构里一个被普遍忽视的漏洞。
传统的数据权限设计有一个隐含假设:只要不给某个人看某个字段,数据就是安全的。所以企业给不同部门配了不同的账号权限,财务能看收入、市场不能看收入,看上去井井有条。
但 AI 助手改变了这个前提。它不再「看数据」,而是把数据算成结论。而结论可以携带原始字段的信息——这在信息安全领域叫聚合推断(aggregation inference):单项数据不敏感,聚合起来就敏感。
换句话说:字段级权限管住了「谁能看表」,却管不住「谁能看由表算出来的结论」。
过去一个问答机器人,一次对话结束就忘了。今天的智能体不一样:为了提高效率,它们会记住用户偏好、记住检索过的文档、记住算过的结果,甚至多个智能体共用一套长期记忆库和缓存。
这带来了实实在在的好处——不用每次重复检索,响应更快、成本更低、体验更连贯。但代价是:记忆成了一个新的、几乎没有权限设计的通道。
企业的数据治理通常覆盖三样东西:数据库、文件服务器、业务系统。而「AI 的记忆」往往不在其中——它可能是一个向量库、一张缓存表、一段会话历史,甚至只是某个云服务里的默认存储。没人给它定归属部门,没人给它配访问策略,也没人审计谁往里面写过什么。
这些都不是玄学,而是工程上可以落地的事。关键在于:要把 AI 的记忆当成一份正式的数据资产来治理,而不是当成一个技术实现细节。
很多企业理解的合规是「数据不出内网」,于是采购了私有化部署,觉得风险就解决了。但上面这个案例恰恰说明:数据没出内网,问题照样发生在一个内网里的共享记忆库上。
私有化解决的是「数据边界」,解决不了「权限边界」与「审计边界」。瀚钦在为本地企业部署 AI 知识库时,会把三件事一起设计:数据放在哪(内网)、谁能取到什么(按岗位授权的检索范围)、事后能不能查(操作日志)。标准验证环境为 1 台服务器 + 5 个客户端 + 5 个部门账号,运行开源模型(如 qwen2.5 7B)加本地知识库,验证周期通常 2–4 周——这 5 个部门账号,恰恰是用来验证「部门之间该看到什么、不该看到什么」的最小实验场。
AI 员工有共同记忆,是效率的一次跃升;但如果没人管得住这份记忆,它就是一次静默的越权。企业真正要建的不是一个更聪明的 AI,而是一套能回答「它凭什么知道这件事」的机制。字段权限管的是过去,记忆权限管的是未来。
因为记忆里的内容往往是计算结果,而不是原始数据。比如「12400 个高价值客户 ID」看起来不含敏感字段,但它是用收入字段筛选出来的。结果一旦进入共享记忆,就脱离了原来的授权上下文,其他部门的 AI 可以直接取用,形成越权。这类风险在信息安全领域称为聚合推断。
字段级权限管的是「谁能看表」,管不住「谁能看由表算出来的结论」。AI 会把数据算成结论并缓存,缓存又可能被其它智能体共享调用,这条通路通常不在传统数据治理范围内。因此还需要记忆级权限、结果血缘标签与检索层二次授权。
私有化解决的是数据边界(数据不出内网),但解决不了权限边界与审计边界——内网里的共享记忆库同样可能越权传播。企业需要同时设计三件事:数据放在哪、谁能取到什么、事后能不能查。瀚钦的标准验证环境为 1 台服务器 + 5 个客户端 + 5 个部门账号,正好用于验证部门间权限隔离。