· 瀚钦(丹东)智能科技有限公司
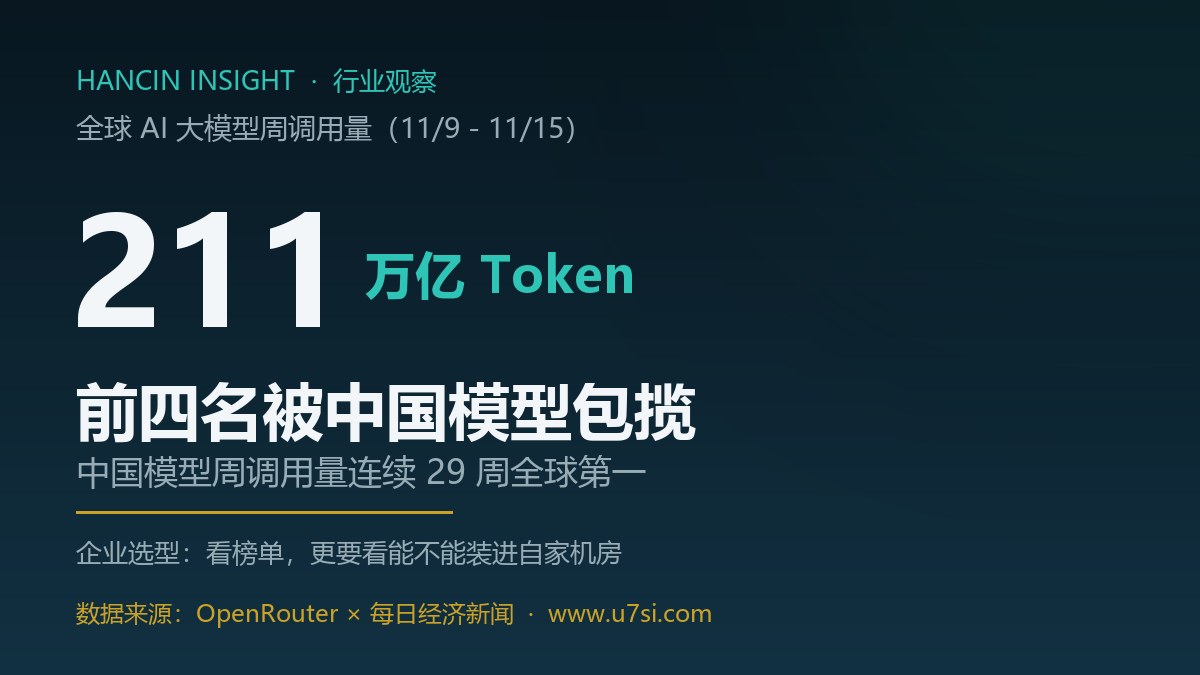
上周(11 月 9 日至 15 日),全球 AI 大模型总调用量达到 211 万亿 Token。《每日经济新闻》根据 OpenRouter 最新数据测算,环比增长 0.48%。这份按周更新的榜单不是跑分榜——它统计的是真实发生的调用,每一次都是开发者或企业「用脚投票」的结果。
榜单里有两个信号值得企业管理者注意:前四名全部是中国模型;同时,这份榜单统计不到的那一半——企业内网私有化部署的调用量,恰恰是增长最快、也最贴近业务的那部分。
按《每日经济新闻》披露的名次,本周榜单是这样的:
前五名中有四款中国模型。更长尾的位置上,小米 MiMo-V2.6-Flash 时隔两周重回榜单,排在第八(4.23 万亿 Token,环比 +88%);智谱 GLM 5.3 位列第九(3.76 万亿 Token,环比 +3%)。此前一周排第八、第九的 MiniMax M3.1 Flash 和 Kimi K3.1 Pro,本周跌出前十。
中国模型总调用量 119.1 万亿 Token、环比增长 2.51%,已连续 29 周超过美国(美国 14.83 万亿,环比 +6.08%)。对做技术选型的人来说,这条新闻的重点不是「谁赢了」,而是:可私有化、可商用的高质量模型,选项比一年前多了一倍不止。
Hy4 的上升曲线值得多看一眼。据《每日经济新闻》报道,相比 preview 版本,Hy4 显著扩展了预训练与后训练的数据和规模,首次引入视觉理解能力,并大幅提升指令遵循、长文理解、长程智能体等综合效果。更关键的是:它首次支持电脑操作(Computer Use),可以结合命令行和图形界面处理工作和生活中的各类任务。
「模型能操作电脑」意味着 AI 从「你问它答」进入「你给目标、它干活」的阶段:填报表、整理单据、跨系统搬数据这类流程型工作,开始可以被智能体接管。单周 42% 的调用量增幅说明,企业客户已经在真金白银地为这种能力买单。
但硬币的另一面是:当模型开始替人操作系统,权限、审计和边界就不再是可选项。哪些文件夹允许它读、哪些操作需要人确认、全过程如何留痕——这些问题决定了智能体能不能放心地用在业务里。
看看这周的环比数字:+42%、+88%、-12%、-10%,再加上两款上上周还在前十的模型直接出局——没有任何一款模型能稳坐钓鱼台。原因不难理解:各家都在快速迭代,发布节奏以「周」计,一个版本的差距就足以改写排名。
这给企业的启示很直接:如果做了一套深度绑定某个模型的方案,三个月后大概率要推倒重来。稳健的做法是把系统设计成模型可替换——底座模型负责推理,知识库、权限体系、业务流程沉淀在与模型解耦的层。模型随榜单换,资产留下。
最后说一个容易被忽略的事实:OpenRouter 统计的是经过第三方 API 平台的调用。而越来越多企业的 AI 用量根本不经过任何第三方——模型装在自己机房,数据不出域,调用发生在内网。这部分用量不在榜单上。
换句话说,公开榜单反映的是云端 API 市场的热度,而企业内网的真实格局可能更偏向开源、可本地部署的模型。这两条曲线会持续拉开:业务越核心、数据越敏感,用量就越可能沉淀在内网。对要把 AI 用到合同、票据、客户数据上的企业来说,这是比排名更值得关注的趋势。
榜单解决「缩小范围」,选型还要看三件事:
瀚钦的标准做法是:1 台服务器 + 5 个客户端,先服务 1 个部门。挑一个最重复、最费人的流程——答疑、票据核对、报表初筛——用两周跑通一个真实场景,再决定往哪里扩。榜单每周都会变,但一个跑通的场景、一套沉淀好的知识库,是能跟着模型升级一直用的资产。
如果你的企业正在评估 AI 落地,欢迎通过官网「免费诊断」预约一次现场评估:我们会带着榜单之外的问题清单来——你的数据在哪里、谁会用、怎么验收。
数据引自《每日经济新闻》对 OpenRouter 平台数据的测算,统计的是 2026 年 11 月 9 日至 15 日通过第三方 API 聚合平台发生的模型调用量。它反映开发者与企业的真实使用情况,但不等于全市场份额——企业内网私有化部署的调用量不经过这类平台,不会被统计进来。
不一定。调用量反映的是生态热度,不等于场景适配度。企业选型更应看三件事:数据是否必须留在内网(决定能否私有化)、中文长文档处理能力(合同、发票、报表场景的关键)、单位 Token 成本与并发能力。榜单帮你缩小范围,场景决定最终选择。
不会。榜单前列的中国模型(DeepSeek、智谱 GLM 等)大多提供开源权重,企业可以在自己的服务器上部署适配版本。模型迭代越快、开源跟进越及时,本地部署的「版本差」就越小。瀚钦的标准 POC 用 1 台服务器承载模型与知识库,两周内即可验证一个部门的真实场景。
会过时的是某个具体模型的排名,不会过时的是知识库和业务流程。建议把长期价值沉淀在与模型解耦的层:文档结构化、权限体系、审批流程、提示词与验收标准都做成通用资产,底座模型可以随技术演进随时替换,前期投入不会白费。