· 瀚钦(丹东)智能科技有限公司
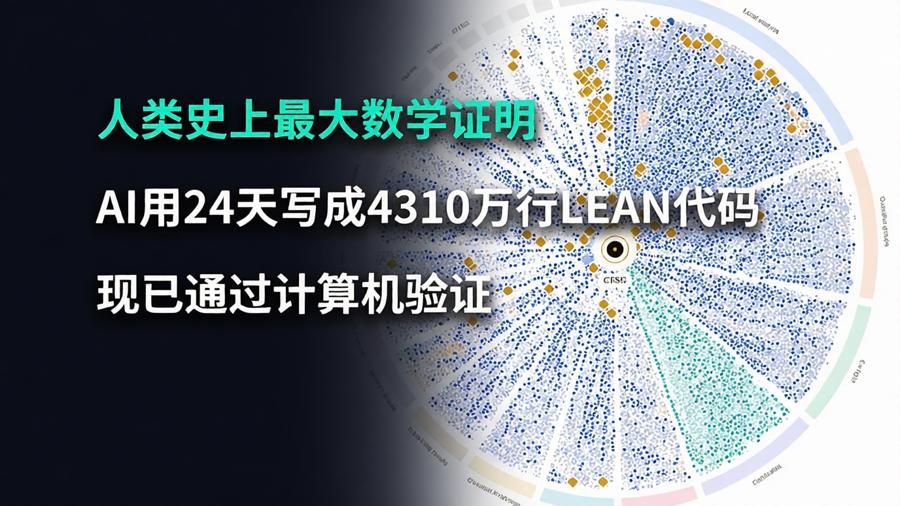
一个困扰人类 167 年的问题,可能正在被 AI 撬动。11 月 20 日,Anthropic 的数学家 Levent Alpöge 在个人网站发布声明,称自己与 Claude 合作找到了黎曼猜想的证明,而且方法还能推广到广义黎曼猜想。
但比「AI 又攻克了什么」更值得企业管理者读的,是这件事随后引发的三场争论——证明可不可靠、成果算谁的、人还要不要理解答案。这三问,恰好也是每一家把 AI 用进业务的企业,迟早要回答的问题。
黎曼猜想由德国数学家伯恩哈德·黎曼于 1859 年提出,是克雷数学研究所七大千禧年难题之一,悬赏 100 万美元。它断言黎曼 ζ 函数所有非平凡零点的实部都等于 1/2——本质是在约束质数分布偏离平均值的程度。人类已经用计算验证了前 10 万亿个零点都符合,但有限范围的验证不等于对无限多个零点的证明。
这次 Alpöge 公布的不是一篇人类可读的论文,而是 14 个压缩包的 Lean 形式化证明文件,约 1700 万行代码;他估计若整理成人类可读的论文,篇幅可能超过 25 万页。他本人也坦言,论证推进到后半程时 Claude 已经明显超出他的理解能力,部分技术描述来自 Claude 生成的总结,可能仍需修订。
所以现阶段的准确说法是:这是一个个人提出的证明主张,尚未经过独立同行验证,Anthropic 也未正式背书;按克雷数学研究所的规则,还需在合格期刊正式发表并经至少两年审查,才进入奖金评定程序。Alpöge 也不是无名之辈——普林斯顿数学博士、导师是菲尔兹奖得主 Bhargava,今年 7 月他还与 Claude 合作提出过雅可比猜想三维情形的反例,且已获独立形式化验证。
数学界没有立即庆祝,第一个原因很技术也很关键:形式上通过检查,不等于命题本身被正确表达。计算机能验证形式化语言里的逻辑推导,却不能自动保证这份代码与人类原本想表达的数学命题完全一致。
今年 10 月就有现成案例:伦敦国王学院与剑桥大学的研究者质疑 OpenAI 公布的一项偏微分方程证明,发现其人类可读版本与对应的 Lean 形式化版本之间存在不一致。这不直接说明结论错误,但说明——「机器点头」和「人看懂了」是两件事。
第二个原因是归属。《莱顿人工智能与数学宣言》今年 6 月发布、获国际数学联盟背书,明确要求:使用 AI 的研究者必须披露工具使用情况、充分引用前人成果,并对最终结论的正确性承担责任。9 月,包括陶哲轩在内的 25 位菲尔兹奖得主联合声明,指出 AI 公司与数学界存在目标错位:数学的意义不止于答案,还在于形成新的概念理解。
第三个原因是:人类还要不要理解答案为什么成立。纽约大学数学家 Buckmaster 的判断是,数学的重要性不仅在于得到结论,还在于人能理解它为什么成立。西北大学的 Bryna Kra 说,数学在过去两个月发生的变化,可能超过过去 100 年——既让人兴奋,也让人不安。
抛开争议,Alpöge 和 Anthropic 披露的过程数据很有意思:今年 8 月,Claude 在尝试黎曼猜想时意外改进了长期结果,把已知位于临界线上的 ζ 函数零点比例下界从 41.6% 提高到 67.2%;它最初尝试了 650 个研究思路均未成功,随后组织约 60 个子智能体分头研究、运行 2400 次命令、编写数百个 Python 脚本、下载 54 篇论文比对核查。
这不是「一个大模型灵光一现」,而是一套可复用的工程结构:大量并行的探索、明确的工具调用、文档检索与交叉核对、失败路径的记录。企业做智能体,最该学的正是这个骨架,而不是期待模型自己变聪明。
黎曼猜想离办公室很远,但这场争论的四个问题,和企业用 AI 高度同构:
至于黎曼猜想最终能否被证明,要等数学界给出答案。但那个更值得记住的追问已经留下:如果 AI 能替人找到答案,人是否还需要理解答案为什么成立——在企业里,这个问题的现实版本是:如果 AI 能替员工干活,管理者是否还需要知道这活是怎么干成的。答案是需要的,而且要提前把「怎么验收」设计进流程里。瀚钦给辽宁企业做私有化部署,做的就是这件事:模型在内网、数据不出域、每个场景都配可核对的验收口径。如果你的企业正在评估 AI 落地,欢迎通过官网「免费诊断」预约一次现场评估。
黎曼猜想由德国数学家黎曼于 1859 年提出,断言黎曼 ζ 函数所有非平凡零点的实部都等于 1/2。它本质是在约束质数分布偏离平均值的程度——质数是现代密码学等领域的基石。它是克雷数学研究所七大千禧年难题之一(悬赏 100 万美元),人类已用计算验证前 10 万亿个零点都符合,但有限验证不等于对所有零点的证明。目前七大难题中只有庞加莱猜想被正式解决。
还没有定论。11 月 20 日 Anthropic 数学家 Levent Alpöge(普林斯顿数学博士、菲尔兹奖得主 Bhargava 的学生)声明与 Claude 合作找到证明,公布的是 14 个压缩包、约 1700 万行的 Lean 形式化证明文件(折算人类可读论文约 25 万页)。这是个人证明主张:尚未经过独立同行验证、Anthropic 未正式背书、也没有人类可读的完整论文;按克雷研究所规则还需期刊发表并经至少两年审查。他本人也承认论证后半程已超出自己的理解能力。
三个原因:① 可靠性——形式化验证通过不等于命题被正确表达,今年 10 月就有研究者发现 OpenAI 某项证明的人类可读版本与 Lean 版本存在不一致;② 归属与责任——《莱顿宣言》(获国际数学联盟背书)要求披露 AI 使用情况、引用前人成果,并对结论正确性承担责任的仍然是人;③ 理解——25 位菲尔兹奖得主(含陶哲轩)联合声明指出,数学的意义不止于答案,还在于形成新的概念理解。纽约大学数学家 Buckmaster 也强调:重要的是人类能理解结论为什么成立。
四问直接可迁移:① 你的 AI 交付物有验收标准吗——不能接受「读起来像」的输出,合同条款、票据金额、报表口径都要有可核对依据;② 关键环节人看得懂吗——留痕、引用来源、可回溯不是可选功能;③ 责任落在谁头上——工具不担责、人担责,对外交付与合规场景必须保留人工确认节点;④ 智能体怎么组织——Claude 这次用了 650 个思路、60 个子智能体、2400 次命令、54 篇文献核查,说明生产可用的形态是「多探索+强校验」的工程结构,而不是一个聊天框包打天下。
瀚钦(丹东)智能科技专注 AI 智能体与知识库私有化部署:模型和数据留在企业内网,每个场景都配可核对的验收口径(原文出处、命中字段、人工确认节点),落地用标准 POC(1 台服务器 + 5 个客户端)先在一个最重复、最费人的流程上跑通真实场景。可通过官网 www.u7si.com 的「免费诊断」预约现场评估。