2026-11-08 · 瀚钦(丹东)智能科技有限公司
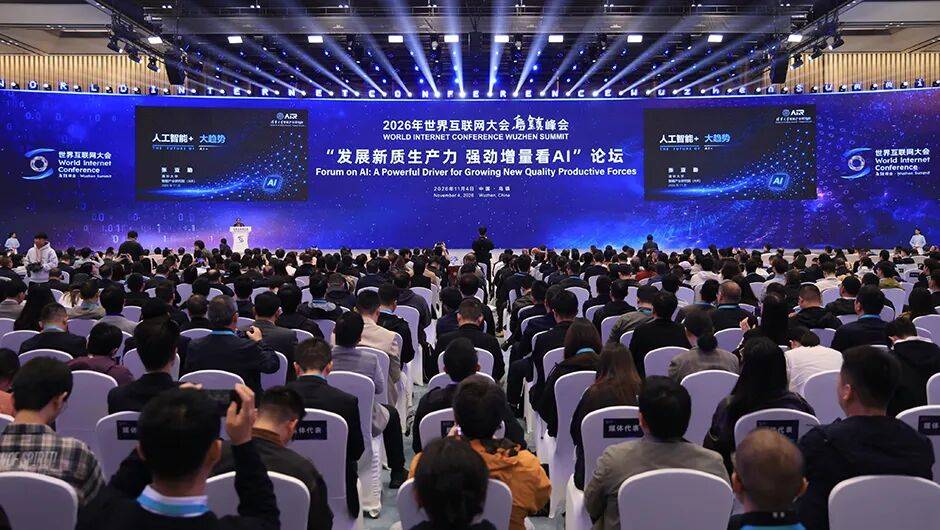
11 月 3 日至 4 日,2026 年世界互联网大会乌镇峰会在浙江乌镇举行。据央视网、中国经济网等媒体报道,本届峰会主题为「开源开放 共建共享——携手构建网络空间命运共同体」,是世界互联网大会首次把「开源」置于主题位置。主论坛的「人工智能乌镇对话」上,中国工程院院士、之江实验室主任王坚与深度求索、阿里巴巴、MiniMax 三家企业代表,围绕开源的价值、治理与普惠连提三问。
对普通企业来说,这场讨论最值得留意的一句话,不是关于 AGI 的远景,而是关于「装在哪儿」:开源模型拉低了 AI 使用成本,更能通过本地部署满足多场景数据安全需求,即便在无网络场景中,前沿智能能力也能灵活落地。
换句话说,模型权重的门槛已经降下来了,接下来决定企业能不能真正用起来的,是数据放在哪、出问题谁接得住、以及有没有人把模型接进具体业务流程。
据央视网《人工智能乌镇对话:开源的价值之问、治理之道和普惠之愿》报道,11 月 3 日的对话由王坚主持,国际人工智能治理协会主席约翰·希金斯、深度求索研究工程师高熙、阿里巴巴 ATH 事业群千问大语言模型项目负责人刘大一恒、MiniMax 首席架构师兼开放平台负责人冯雯参与,主题是「全球人工智能开放共建」。
王坚的第一个问题是:今天开源开放的模型到底处在怎样的状态。他的判断是,软件时代中国更多是开源思想的受益者,人工智能时代中国变成了重要的贡献者。高熙给出的开源理由很直接——「为了让 AGI 更快到来」,与其用技术壁垒阻拦同行追赶,不如让技术红利更早惠及所有人。
第二个问题关于安全。第三个问题关于技术向善与普惠。三个问题串起来,恰好是企业引入 AI 时会依次撞上的三道题:为什么用、敢不敢用、谁能用上。
刘大一恒在对话中提到,三年前他亲手完成千问第一代 7B 模型的预训练并开源,至今团队已陆续开源 460 多款模型。他把开源的价值拆成两条:一是加速创新,让技术不再掌握在少数主体手中;二是实现普惠,撑起产业落地的「最后一公里」。
第二条的表述值得企业侧逐字读:开源模型拉低了 AI 使用成本,更能通过本地部署满足多场景数据安全需求,即便在无网络场景中,前沿智能能力也能灵活落地。
这不是顺带一提。冯雯在同一场对话里给出了呼应——模型进入行业深水区,许多国家和企业都有专属的私有数据,「开源模型成了大家做更自主可控模型的选择」。据中国青年报报道,她还有一句更凝练的说法:开源不只是把模型「交出去」,也是在把模型安全地「留下来」;开源模型已成为私有化部署、打造自有模型非常好的基础底座。
世界互联网大会电子商务专委会副主任委员陈柏珲在蓝皮书发布时也从另一个角度提到,开源开放降低了技术门槛和使用成本,可以使中小企业用得上、用得起人工智能。
把这几句话放在一起,指向其实很清楚:开源把能力交到了企业手里,而企业要接住它,需要的是一套自己能控制的部署环境。
但对话没有停在乐观里。
希金斯认为,人工智能已在各领域显著提升生产力,真正的问题不是技术,而是信任。他举了一个身边的例子:一位银行董事长朋友对在银行内部使用开源 AI 感到担忧,因为有时完全搞不清模型的来源背景。
「如果企业只敢把模型部署到次要场景,其挑战在于『如何展示自信』。」据峰会公开报道,这是希金斯对信任问题的原话。
刘大一恒把开源模型的安全挑战拆成两点:一是不可撤回性,模型开源后传播面广,问题难以像闭源模型那样随时在线修复;二是没有外伸的护网,安全很依赖模型内生能力。他的结论是,解决模型安全风险是整个生态的问题,靠限制模型发展难以解决治理问题,未来需要更多人群来关注。
高熙也没有回避:无论开源还是闭源,模型都存在安全风险,开源有可能放大其中一部分;深度求索正在探索通过模型分析、限制部分能力等方式应对,相关研究仍在推进。希金斯则建议,「开源世界」需要社区共建与责任共担,建立共同的评估测试与跨国认证体系,为全球市场提供可信依据。
对企业而言,这段讨论的现实含义是:选开源模型不等于把安全责任外包出去,恰恰相反,模型进到自己机房之后,边界、权限、审计、回滚都得自己立规矩。
峰会前后发布的两份报告,给出了产业侧的背景。需要说明,两组数字来自不同机构、不同统计时点,不宜混用。
其一,11 月 4 日发布的《中国互联网发展报告2026》蓝皮书(中国网络空间研究院编写)显示:2025 年中国企业级 AI 智能体市场规模跃升至 212 亿元,具身智能市场规模约 9150 亿元;截至 2026 年 6 月,累计有 924 款生成式人工智能服务完成备案;2026 年 3 月,我国日均词元调用量攀升至 140 万亿,两年间增长超千倍。
其二,10 月 31 日中国电子信息产业发展研究院发布的《新域新质创新发展十大趋势》显示:截至 2026 年 6 月,日均词元调用量超过 175 万亿,我国人工智能推理数据量首次超过训练数据量,标志着从模型训练研发阶段迈入规模化产业应用阶段;国产算力、大模型已在钢铁、汽车等 20 个行业落地 1000 多个应用场景。
赛迪研究院党委书记、副院长刘文强在发布时的表述是,人工智能正从「喂模型」的实验室阶段,全面转入「用模型」的产业落地阶段。
一个是 3 月的 140 万亿,一个是截至 6 月的超 175 万亿;一个看市场规模与备案数量,一个看推理与训练的结构性反转。但两份报告指向同一件事:行业的话题中心,已经从「谁的模型更强」转向「谁真的在用、用在哪、用得稳不稳」。
把峰会观点和这两组数据叠起来看,会得到一个对企业更实用的判断:模型免费下载,不等于 AI 落地免费。
开源解决的是「拿得到、用得起」,但企业真正要付的成本在后面几步:把散落的制度、单据、工艺文件整理成可检索的知识库;把模型接进现有业务流程并设定人工复核点;确定哪些数据绝不能出门;以及上线之后的权限、日志、版本与运维。BDO 的一项审计创新调研也提到,AI 工具在金融财务领域的应用普及已相当高,但配套治理体系的成熟度明显滞后——技术跑在治理前面,是当下相当普遍的现状。
变化在于,开源让这些工作第一次对中小机构变得可做:不再需要先采购一整套闭源平台,一台服务器加一个合适的开源模型就能起步,先把低风险的知识库问答、制度检索跑通,数据留在自己可控的环境里,断网也能用,跑顺了再逐步扩到文书辅助、运营分析。
本地企业常见的顾虑,往往不是「AI 能不能做」,而是「数据给出去不放心」「没人维护」「不知道从哪个场景下手」。乌镇这场对话给出的行业共识,恰好回应了前两条:本地部署是开源模型被明确点名的价值之一,而治理与信任需要企业自己建立规则、也需要在本地找到能长期陪跑的实施方。
瀚钦(丹东)智能科技做的是 AI 知识库与本地化部署:以开源模型为底座,一台服务器即可起步,知识库问答、制度检索、文书辅助等场景数据不出企业、断网可用,按「知识库 — 文书辅助 — 运营分析」分阶段扩展,每一步都能单独验收。我们提供免费在线体验与 30 分钟业务诊断,方便企业在动手之前先看清自己的数据就绪度和第一个该做的场景。
说明:本文根据公开报道与公开报告整理,瀚钦未参与 2026 年世界互联网大会乌镇峰会及相关对话,文中引述观点均属原发言人与原发布机构,不构成合作背书或客户案例。
不是。开源解决的是「拿得到、用得起」,但落地成本在后几步:把制度、单据、工艺文件整理成可检索的知识库,把模型接进业务流程并设定人工复核点,确定哪些数据不能外传,以及上线后的权限、日志、版本与运维。好处是门槛显著降低——一台服务器加一个合适的开源模型就能起步,先跑低风险场景再逐步扩展。
阿里巴巴千问大语言模型项目负责人刘大一恒在 2026 年乌镇峰会「人工智能乌镇对话」中指出,开源模型能通过本地部署满足多场景数据安全需求,即便在无网络场景中也能灵活落地;MiniMax 首席架构师冯雯也提到,开源模型已成为私有化部署、打造自有模型的基础底座。本地部署的价值是数据不出企业、断网可用、权限与版本可审计,代价是运维责任由企业自己承担。
中国电子信息产业发展研究院 10 月 31 日发布的《新域新质创新发展十大趋势》显示,我国人工智能推理数据量首次超过训练数据量,标志着从模型训练研发阶段迈入规模化产业应用阶段;国产算力、大模型已在钢铁、汽车等 20 个行业落地 1000 多个应用场景。对中小企业的含义不是「赶紧上大模型」,而是行业已进入「用模型」阶段,可以从知识库问答、制度检索这类可验收的低风险场景切入。