2026-11-11 · 瀚钦(丹东)智能科技有限公司
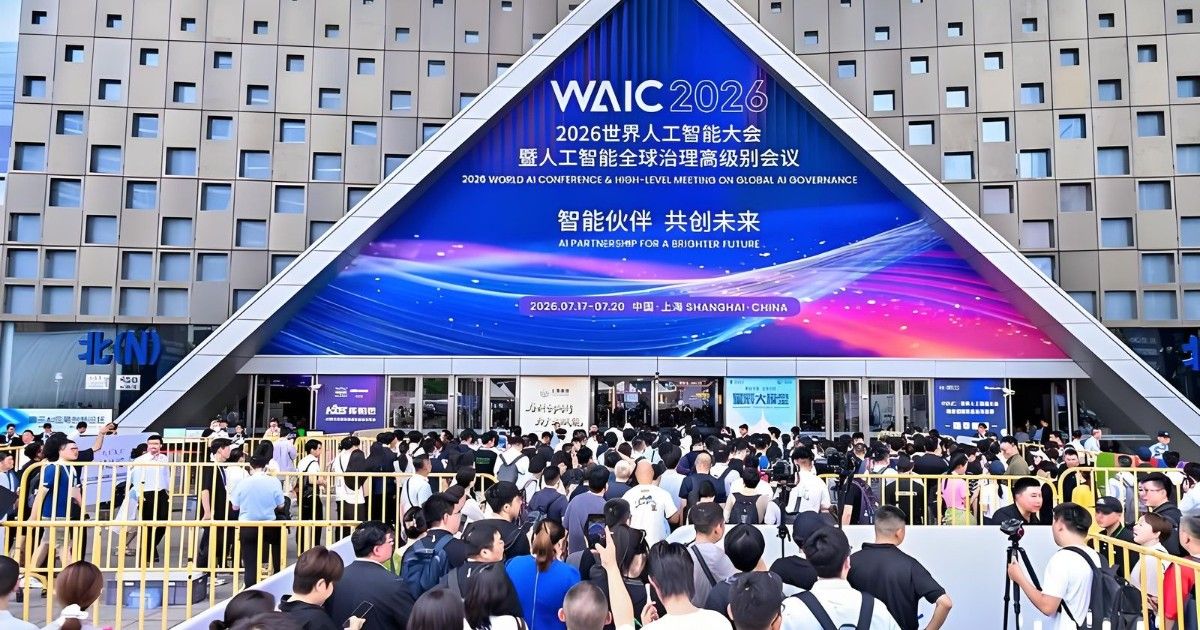
11 月 4 日下午,2026 年世界互联网大会乌镇峰会的「人工智能赋能科学研究」论坛在乌镇互联网国际会展中心举行。论坛上发布了三项 AI for Science 成果,同时,沙利文《2026 年中国 AI4S 科研智算基础设施市场研究》报告也在会上被反复引用。
据环球网科技 11 月 6 日报道,中科曙光高端计算总工程师卜景德在论坛上给了一个判断:AI for Science 真正的瓶颈,已经不再是模型能不能提出问题,而是验证能不能跟上。
这句话放在一堆「全球首次」「世界纪录」中间,容易被忽略。但它其实是整场论坛最值得记的一句——因为它描述的不是某一项成果,而是一类结构性的困难。而这套困难,跟一台十万卡的集群、跟一个部门里那台服务器,是同一套。
科学研究的流程大致是三段:提出假设、用模拟或实验检验、根据结果修正判断。AI 在第一段已经很强,第三段也在快速变强,最难的是中间那段——验证。
验证之所以难,是因为它既要快,又要可信。算得慢,一天只能试几个方案,AI 提假设的速度就白费了;算得不可信,跑出来的结果没人敢用来做决策,那还不如不算。
中科曙光给出的解法是「超智融合」:把高精度科学计算和低精度 AI 训练推理放进同一套系统。卜景德的说法是,超智融合不是把超算和智算简单拼在一起,而是让同一套系统同时承载两类负载——这正是为了把「提出问题」和「验证问题」放进同一个闭环。
这个思路听起来是国家级基础设施的事,但它背后那条逻辑,任何做过信息化项目的人都熟:工具之间不通,人就得在中间搬数据;搬得越多,可信度掉得越快。
材料科学长期受困于精度与规模的矛盾。第一性原理计算精度高,但只能处理数百个原子;分子动力学模拟能上规模,却难以兼顾量子精度。两头都够不着真正有用的尺度。
据中科曙光公开信息,其联合龙讯旷腾、苏州实验室及樊哲勇教授团队,依托曙光 8000 超智融合算力底座与 MatPL 机器学习力场软件,首次实现具有量子力学精度的万亿原子分子动力学模拟。中科曙光官网披露的技术细节更具体:单原子单次更新耗时低至 5.0×10⁻¹³ 秒,从单卡扩展到大规模并行集群时,弱扩展效率达 86.9%,通信占比仅 4.26%。
后面那两个数字,其实比「万亿原子」这个纪录本身更能说明问题。前者意味着规模扩大近十倍时效率只掉一成多,后者意味着时间几乎没花在等数据上。换句话说,这个成果不是因为买了足够多的卡,而是因为并行效率和通信开销被压到了极限。
要让机器学习力场在国产异构环境里大规模并行训练,还要跟分子动力学模拟在同一底座上衔接,中间要处理的是国产加速卡的内存约束、跨节点通信效率、任务调度策略——这些活儿没有一个能靠采购解决。
科学成果好不好,同行评议是一种标准,但能不能进业务系统是另一种标准,后者更硬。气象正好是后一种。
据公开报道,2026 年 9 月,中科曙光与中国气象局地球系统数值预报中心联合发布 MCV 数值模式成果:依托全国产十万卡 AI 超集群,MCV 在 1 小时内完成全球 5 公里分辨率、未来 10 天预报计算,并通过批量预报质量检验。对气象业务来说,这意味着预报时效和计算时效同时进入了国际主流业务标准区间。
同一条线上还有两个成果。国家气象中心牵头研制的「风清」人工智能全球短中期集合预报系统 V1.0,据中国气象局业务化评审的检验结果,基于 2025 年 1 月至 2026 年 8 月独立样本,全球集合平均预报 500 百帕位势高度有效预报时效达到 11.0 天,CRPS、离散度—误差比等关键指标表现良好,部分指标优于欧洲中期天气预报中心(ECMWF)的数值集合预报系统和 AI 集合预报系统。海洋方向,崂山实验室等单位联合开发的 swLFS 全球海洋环流预报系统,据环球网报道首次实现 1 公里分辨率、百亿网格规模模拟,海表温度后报均方根误差约为欧洲 GLO-MFC 系统的一半。
这里有个细节值得注意:「风清」不是纯数据驱动的科研模型,它在 Swin Transformer 里引入了大气物理守恒约束,并配套扰动生成模块抑制自回归漂移。也就是说,它把物理规律当成了约束条件写进模型,而不是指望模型从数据里自己学会。
这套思路的实用性在业务里验证过:据报道,2024 年 9 月台风「摩羯」登陆前 6 天多,「风清」就锁定了登陆路径;去年 8 月,它提前 8.5 天预报出华北的分散性暴雨。
那份市场研究报告里,有几组数字和几句判断,比成果发布更适合拿来做标尺。
市场规模:据沙利文报告,中国科研机构 AI4S 基础设施潜在市场规模预计由 2025 年的 420.7 亿元增长至 2027 年的 760.7 亿元,2030 年达到 1,480.1 亿元,2025—2030 年复合增长率约 28.6%。
成熟度:沙利文报告把高校科研机构的 AI4S 应用分为三档——局部课题组应用占比最高,为 34%;多实验室、多学科拓展应用占 27%;已形成校级或院级平台化应用的仅占 15%。
这组 34% / 27% / 15% 的分层(数据据沙利文报告),可能是全文最有用的一个数据。连科教资源最富集的高校,绝大多数也还停在「一个组、一个课题」的单点试点上,真正做到平台化的不到六分之一。如果连高校都是这个结构,企业不必因为「还没做成平台」而焦虑,但也不该把单点试点当成已经落地。
评价标准:沙利文报告指出,行业的关注点正由 GPU/NPU 数量、理论峰值和节点规模,转向多卡并行效率、网络通信、存储吞吐、任务调度和长周期稳定运行能力。报告还提到,曙光 8000 十万卡 AI 超集群日均处理作业超过 15 万,已完成 300 余项重点应用深度适配,试运行阶段完成的 70 余项万卡规模测试中弱可扩展性达 98.4%。
报告给这类能力起了个名字,叫「有效算力释放」——不是理论峰值,而是真实任务里真正被用上的那部分算力。它的原话更狠:任何一个环节出现短板,都会导致算力闲置、通信等待或任务中断。
这篇报道里有一段容易被跳过的内容,讲的是成果背后的合作方式,反而对甲乙双方都有参考价值。
材料模拟中,中科曙光团队与龙讯旷腾围绕国产加速卡内存约束、跨节点通信效率和任务调度策略做深度适配;气象模式迁移中,两边团队在调度系统、通信库和计算单元适配上反复调试——因为国产异构环境中不同计算单元的运行结果能否严格一致,直接决定数值模式能不能通过业务化检验;深部物探中,团队适配 SLURM 调度体系,开发跨节点多国产加速卡自适应资源分配算法;火箭尾焰模拟对跨节点并行效率和长时间稳定运行要求极高,系统级资源调度与故障恢复机制成了任务完成的底层保障。
这些工作有一个共同点:它们都不是设备清单上的一行。买得到机器,买不到「结果严格一致」,也买不到「弱可扩展性 98.4%」。
上海交通大学智能计算研究院院长葛冬冬的评价抓的正是这一点:十万卡超集群的意义在于第一次让超智融合从概念变成可运营的基础设施,让更多科研团队低成本、低门槛使用。「可运营」三个字是关键——建起来不算,能长期跑住才算。
这套逻辑从国家级基础设施搬到一间企业的机房里,会缩水,但不会失效。
第一,「有效算力」这个概念先用起来。 企业买了几张卡、装了什么型号的服务器,这些是峰值指标,不说明任何问题。真正该问的是:这套东西一周里有几个小时在跑真实任务?有多少时间花在等数据、等人工核对、等人来重启?这个比例算出来,往往比选型讨论有用得多。
第二,别把「单点试点」当成「已经落地」。 沙利文那组 34% / 27% / 15% 的分层说明,从「一个组在用」到「组织级平台」中间隔着两级台阶,而跨过这两级台阶靠的不是加算力,是数据治理、调度和持续服务能力。企业更现实的做法是先在一个部门跑稳,把流程和责任人定下来,再谈推广。我们在 AI 部署方案 里的四档版本划分,就是按这个节奏设计的。
第三,把「谁负责让它一直跑」写进方案里。 气象那边的成果之所以能进业务系统,是因为有一批人在调度系统、通信库、计算单元上反复调试,把「结果严格一致」这件事做到了。企业侧的对应版本更朴素:数据谁维护、答错了谁复核、模型更新谁签字、日志留多久。这些没定,系统上线三个月就会变成没人管的黑盒。
如果你正在评估要不要上、上到什么程度,可以走一次 免费诊断。我们会先看数据底子和场景清单,再谈设备与部署方式——顺序反了,钱大概率白花。
信息来源与说明:本文依据环球网科技 2026 年 11 月 6 日报道《世界级科研突破背后的中国算力:AI4S 从「单点突破」迈向「系统能力建设」》(记者李文瑶)、中科曙光官网公开信息、沙利文《2026 年中国 AI4S 科研智算基础设施市场研究》公开摘要,以及中国气象局「风清集合 V1.0」业务化评审相关公开报道整理。文中技术指标、市场规模与检验结果均按上述公开来源表述,「首次」「世界纪录」等定性说法为原报道与厂商公开口径,本文未作独立验证;「风清」的对比结论按中国气象局业务化评审的检验口径,写作「部分指标优于」。瀚钦未参与上述任何论坛、项目与合作,本文不涉及客户案例、合作背书或政策解读,提及的技术与产品信息仅作行业观察之用。
指真实任务里真正被用上的那部分算力,而不是芯片的理论峰值。沙利文在《2026 年中国 AI4S 科研智算基础设施市场研究》里的表述是:评价标准正由 GPU/NPU 数量、理论峰值和节点规模,转向多卡并行效率、网络通信、存储吞吐、任务调度和长周期稳定运行能力。报告还指出,任何一个环节出现短板,都会导致算力闲置、通信等待或任务中断。对企业来说,这个指标的朴素版本就是:这套系统一周里有几个小时在跑真实任务,又有多少时间花在等数据、等人工核对、等人来重启。
纪录本身没关系,它们成立的原因有关系。万亿原子模拟能做成,靠的是弱扩展效率 86.9%、通信占比仅 4.26%——也就是规模扩大近十倍效率只掉一成多、时间几乎没花在等数据上。气象模式能进业务系统,靠的是在调度系统、通信库和计算单元上反复调试,让不同计算单元的结果严格一致。这两件事说明:决定成败的不是买了多少卡,而是并行效率、通信开销和结果一致性。企业规模小得多,但被卡住的位置是同一处。
沙利文报告把高校科研机构的 AI4S 应用分了三档:局部课题组应用占比最高,为 34%;多实验室、多学科拓展应用占 27%;已形成校级或院级平台化应用的仅占 15%。这说明连科教资源最富集的高校,绝大多数也还停在单点试点。对企业的启示是双向的:不必因为还没做成平台而焦虑,但也不要把「一个部门在用」当成已经落地——从单点到平台中间隔着两级台阶,跨过去靠的是数据治理、调度和持续服务能力,不是加算力。