2026-11-10 · 瀚钦(丹东)智能科技有限公司
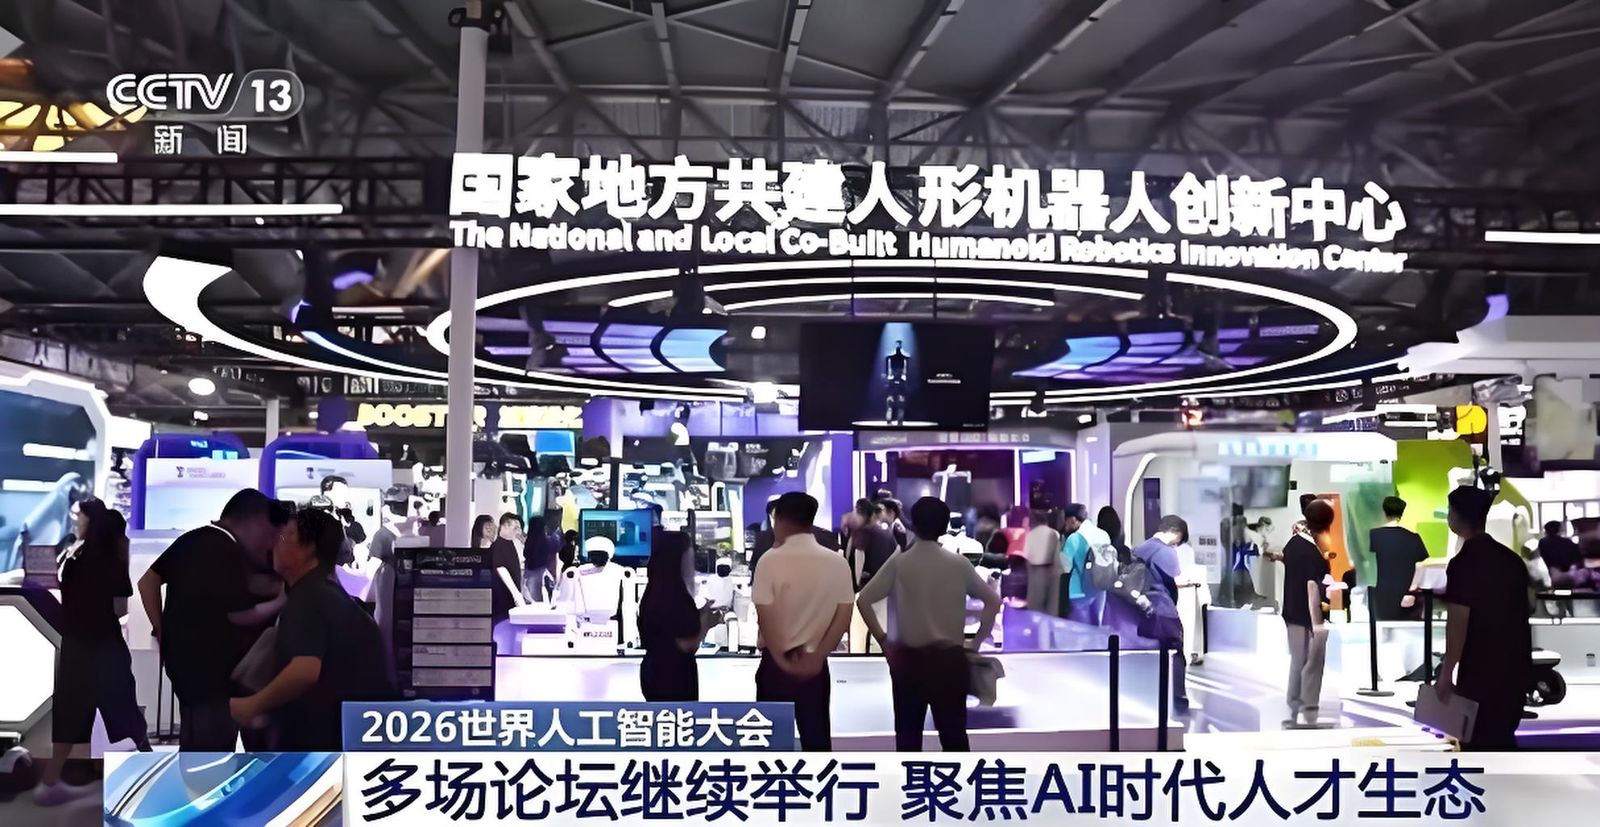
11 月 8 日,2026 人工智能创新生态大会在合肥举行。据大皖新闻与主办方公开通稿,这场会来了 1200 余人,院士、高校校长、企业技术负责人同台。会议主题是「数智江淮 科创兴皖」,由合肥综合性国家科学中心人工智能研究院有限公司与华为联合主办。
会上有一个细节值得单独拎出来:中国科学院院士、中国科学技术大学校长常进讲的是「打通成果转化死亡之谷」,华为常务董事、ICT BG CEO 杨超斌讲的是「打通 AI 行业落地最后一公里」。两个说法听起来是两个话题,其实是同一件事的两端——一头是实验室的成果出不来,一头是企业的场景进不去,中间断掉的都是同一段路。
对不在会场里的企业来说,这场会真正有用的信息不是谁讲了什么愿景,而是供给端正在往哪个方向动。
杨超斌在致辞里讲的是「超节点+集群」的架构创新和 CANN 开源,落点在为中国算力提供底座。这个层级的表述离中小企业很远,但同一天另一场研讨会上的话就具体得多。
据 C114 通信网对大会「人工智能生态研讨会」的报道,华为边缘计算一体机产品线总裁王庆文提到,当前大模型发展除了布局大规模超节点,也会陆续推出 8 卡、16 卡一体机乃至更小算力的产品,目标是让 AI 真正进入千行百业,以高安全标准实现开箱即用、按需部署。他还提到,华为已将 CANN 及推理加速技术开源,未来计划开源企业级 Agent 加速套件。
这段话的信号很明确:算力供给正在分层。万卡集群服务的是训练大模型的少数玩家,8 卡、16 卡一体机服务的是想把模型放进自己机房的大多数企业。前者是国家级基础设施,后者才是本地部署的现实选项。
同一场大会上的另一个动作也指向同一处。据主办方通稿,华为安徽算力 MaaS 生态伙伴联盟当天成立,以昇腾 AI 技术为核心,首批发起单位包括北京趋境科技、中软国际、软通动力、合肥中科类脑、清昴智能等,定位是构建「算力供给-场景落地」一体化的 MaaS 服务生态。同期还有科大讯飞、合肥物质科学研究院、美亚光电、容知日新等十家单位联合发布了面向教育、医疗、制造等领域的昇腾全链路行业解决方案。
把这三件事连起来看:芯片和整机往下做小,工具链往上开源,中间用联盟和行业方案把「买算力」和「用起来」缝在一起。这是一条完整的降门槛路径。
产业侧的第二个信息来自科大讯飞。据大会公开信息,科大讯飞联合创始人、认知智能全国重点实验室主任胡国平介绍,星火 X2.6 依托自主创新算力,在代码与智能体能力上取得突破,攻克了自主创新芯片长程训练推理的技术难题,在教育、医疗领域的能力达到行业专家水准,并在央国企市场实现规模化落地。
他给的一个判断是:全链路自主创新的端云一体大模型,是 AI 安全与高性价比发展的重要路径。
这句话对准备做私有化部署的企业有两层含义。一是「端云一体」意味着不必所有推理都放在云上,一部分可以落在本地设备,成本和时延都能降下来;二是「全链路自主创新」直接关系到供应链的可持续性——如果一家企业的 AI 系统要在本地跑五年以上,芯片、框架、工具链的长期可获得性,比当下的跑分更重要。
主题报告环节的四位讲者,讲的领域跨度很大:脑科学、算力网、医工融合、世界模型。但四个人不约而同地都提到了自己那条路上的瓶颈,这部分比成果展示更值得读。
脑机接口——浙江大学医药学部学术委员会主任、脑机智能全国重点实验室首席科学家段树民说,神经调控距脑机接口仅一步之遥,医疗应用将是先行场景,而无创精准调控技术的突破才是它真正走向未来产业的关键。换句话说,能做的和能大规模做的,中间隔着一项还没攻克的技术。
算力网——鹏城实验室主任、北京大学博雅讲席教授高文借鉴电力网的演进逻辑解读算力网建设,提出分算力汇聚、任务调度、协同计算三阶段推进。据公开报道,当前建设面临算力供给、超宽带网络、跨域调度、算电协同、数据安全多重挑战,实践依托鹏城云脑 III、WRDMA 高速互联等技术,目标是让算力像电力一样可跨地域按需调用。
医工融合——加拿大工程院院士、美国生物医学工程院院士、复旦大学浩清特聘教授陈颉指出,当前非动物评价的核心瓶颈在于构建完整的临床证据链,提出要形成「模型-评价-验证-迭代」的闭环。
世界模型——加拿大工程院外籍院士、智象元一创始人兼首席执行官梅涛认为,AI 正在演变为社会基础设施,而物理建模不足、真实交互数据稀缺是制约物理 AI 发展的共性难题,世界模型是破局的关键。
四个瓶颈,四句话,其实指向同一个规律:技术突破只是拿到入场资格,能不能真正用起来,取决于边界条件——一项关键技术的成熟度、一套跨域调度的机制、一条完整的证据链、一批足够真实的交互数据。这些东西没有一样是靠模型参数堆出来的。
大会的合作签约环节有三组:智能院与华为深化合作,围绕科研信息基础设施建设、智能算力与数据存储支撑、本地生态工具链共研开展协同攻关;智能院与国仪量子战略合作,聚焦重大科研项目联合谋划、关键技术协同研发、人才联合培养;智能院与江苏集萃智能制造技术研究所共建具身视觉认知与 VLA 技术联合实验室。
签约本身是常规动作,值得看的是它背后的组织方式。据大会同期研讨会的信息,安徽省科技厅人工智能处在会上解读了两份文件:《打造通用人工智能产业创新和应用高地若干政策(2.0 版)》与《安徽省「人工智能+万物」应用行动方案》。后者提出实施「十百千万工程」——聚焦十大重点方向、统筹布局百个重点领域、推动千家主体联动、实现万项应用落地。
同时,大会还设了八场专题研讨会,分别是人工智能生态、算电协同、鸿蒙生态、AI+制造、生命医学与智能前沿产业、研究院成果发布、AI+脑机接口、世界模型与具身智能。
政策给方向、院所出成果、企业出算力和产品、八场会分头对接具体行业——这是一个省级生态的完整结构。它不依赖某一家企业把事做完,而是把不同环节的角色都摆到台面上。
这场会在合肥,讲的是安徽的事。但有三条判断,放到任何一个省份、任何一家准备做 AI 的企业身上都成立。
第一,先确认自己需要的是哪一档算力。 供给端已经在分层,8 卡、16 卡的一体机就是为中小企业准备的。多数企业真正要跑的不是千亿参数训练的活儿,而是每天成百上千次的推理。想清楚这一点,预算会差出一个数量级。我们在这个问题上的一般建议是:先用一台服务器跑通一个部门,再谈扩容。
第二,把瓶颈找在技术之外。 四位院士讲的四个瓶颈,没有一个在模型上。企业里的情况也类似:数据散在几个系统里对不齐、答错了没人能追、权限收不回来、没人说得清这套东西该由哪个岗位负责。这些事做完,往往比换一个更强的模型更有用。可参考我们的 AI 部署方案 里的四档版本划分。
第三,按「能否复制」而不是「是否先进」来选第一个场景。 大会设了八场按行业划分的研讨会,这个安排本身就说明:AI 落地是按行业、按场景走的,不是按模型走的。企业在选第一个试点时,最好挑那种每周反复发生、判断标准相对稳定、错了也能兜住的活儿。
如果你正卡在「不知道从哪一步开始」,可以走一次 免费诊断,我们会先看数据底子和场景清单,再谈要不要部署。
信息来源与说明:本文依据大皖新闻 2026 年 11 月 9 日报道《院士专家与产业大咖同台 2026 人工智能创新生态大会在合肥举行》(记者项磊)、大会主办方公开通稿,以及 C114 通信网对大会「人工智能生态研讨会」的报道整理。所引院士、企业负责人职务与发言,均按上述公开报道表述;会议数据为公开通稿口径。瀚钦未参与本届大会及相关签约、联盟与项目,本文不涉及客户案例、合作背书或政策解读,提及的技术与产品信息仅作行业观察之用。
不是某位院士的愿景表述,而是算力供给开始分层。据大会同期研讨会公开报道,华为在布局大规模超节点的同时,也会陆续推出 8 卡、16 卡一体机乃至更小算力的产品,方向是开箱即用、按需部署。万卡集群服务的是训练大模型的少数机构,一体机服务的是想把模型放进自己机房的大多数企业。对准备做本地部署的企业来说,后者才是现实选项。
四位讲者分别讲脑机接口、算力网、医工融合、世界模型,领域跨度很大,但都提到了自己那条路上的瓶颈:无创精准调控技术、跨域调度与算电协同、完整的临床证据链、物理建模与真实交互数据。四个瓶颈没有一个在模型上。企业做 AI 时遇到的卡点也类似——数据对不齐、答错追不了、权限收不回、责任定不下,这些都在技术之外。
可以照搬三个判断:一是先确认自己需要哪一档算力,多数企业跑的是每天成百上千次推理,不是千亿参数训练,想清楚这点预算会差一个数量级;二是把瓶颈找在技术之外,先做数据清点、权限收窄、日志留痕;三是按「能否复制」而不是「是否先进」来选第一个场景,挑那种每周反复发生、判断标准相对稳定、出错也能兜住的活儿。