2026-11-01 · 瀚钦(丹东)智能科技有限公司
10 月 29 日,辽宁省工信厅同时公示了两份名单:95 个“人工智能+制造”典型应用案例,和 11 个高质量行业数据集,公示时间为 10 月 29 日至 31 日。
前一份名单热热闹闹,后一份只有 11 项,容易被忽略。但我们的判断恰恰相反:这份短名单,才是更值得企业主认真读的那份。
行业里有个通俗的说法:大模型是发动机,数据是油。通用大模型再强,也不认识你厂里那台设备的故障代码、看不懂你的工艺卡、算不准你的损耗规律——这些它没学过,因为它没见过你的数据。
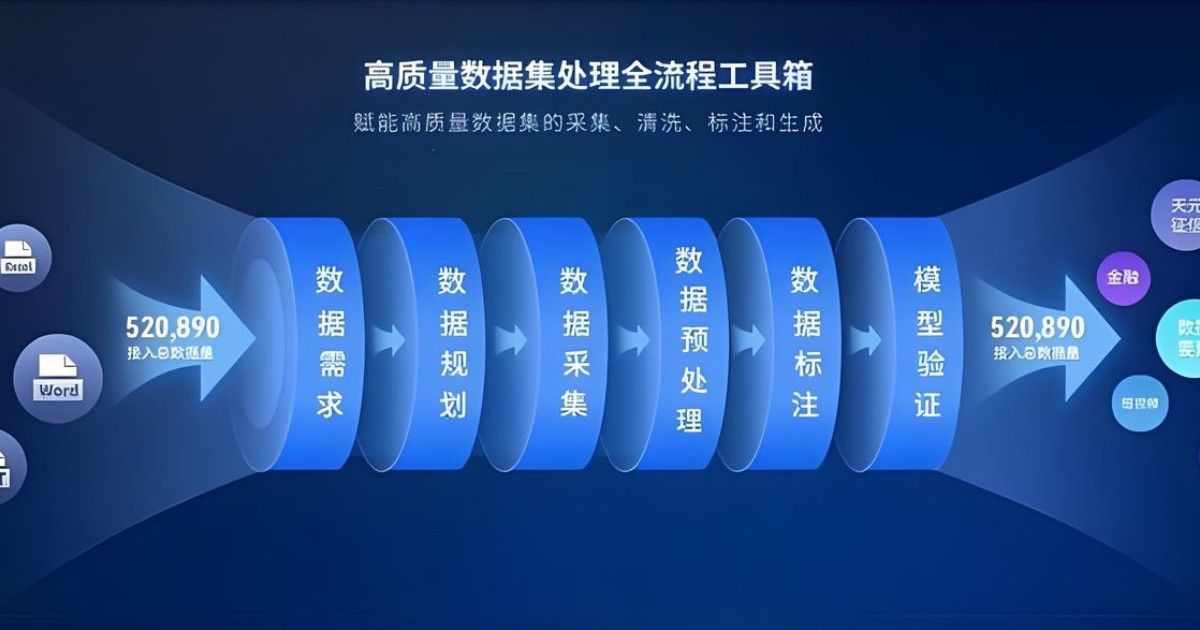
要让 AI 真正懂一个行业,就得把行业数据整理成机器能消化的形态:标注好的故障案例、结构化的工艺参数、带时间戳的设备状态序列。这就是“高质量行业数据集”——它决定了行业模型的水平上限。
省厅专门为“数据集”单设一个遴选序列,说明主管层面看得很清楚:应用可以百花齐放,原料必须统一标准。
其一,通识层几乎空白。11 个里只有 1 个行业通识数据集(沈阳机床的 AI 机床故障诊断助手),其余 10 个全是“专识”——围绕具体企业的具体场景。通用行业知识的公共底座,还没人做出来。
其二,集中在沈大鞍营。沈阳 5 个、大连 3 个、鞍山 2 个、营口 1 个。鞍钢数智科技拿了 2 个(热轧产线视觉工序、PLC 通信信号),加上它在案例名单里的 6 个,是全省最大的“数据+应用”玩家。
其三,丹东是空白。丹东在这份名单上没有一家。对照案例名单丹东还有 2 家企业上榜——应用有人做了,但把数据沉淀成资产这一步,全省还没有丹东企业的位置。
这份名单对企业最实际的启发是:你厂里的数据,本身就是资产。
工艺参数、质检记录、设备维修日志、客服对话、客户台账——这些每天产生却被散落在 Excel、聊天记录和老师傅脑子里的东西,按标准整理出来,就是高质量行业数据集的雏形。它有三重价值:
换句话说:做知识库是攒资产,不是买软件。早一天结构化,早一天进正循环。
瀚钦(丹东)智能科技的核心服务正是这一层——把企业散落的知识和记录,沉淀成“数据不出厂、答案有出处”的私有知识库,并为有意愿的企业按省级标准整理数据集申报材料。想评估自己企业的数据家底,欢迎联系我们做一次免费诊断。
注:名单完整版可登录辽宁省工业和信息化厅官网查询;公示时间为 2026 年 10 月 29 日至 31 日。
由省工信厅年度遴选确定,指经标准化整理、可供人工智能训练使用的行业数据资源。2026 年辽宁首批确定 11 个,分行业通识和行业专识两个方向。
数据整理与企业知识库一样遵循私有化原则——数据留在企业自己的服务器上,不出厂、不上公有云;进入省级遴选的申报材料只涉及脱敏后的样例与说明,商业化核心数据始终在企业手里。
绝大多数企业的起点都是这个状态。实践路径是先从单一场景切入(如设备维修记录或客服对话),用知识库工具边用边沉淀,积累到一定规模再按标准整理申报。起点不在数据量,在于开始。