2026-11-09 · 瀚钦(丹东)智能科技有限公司
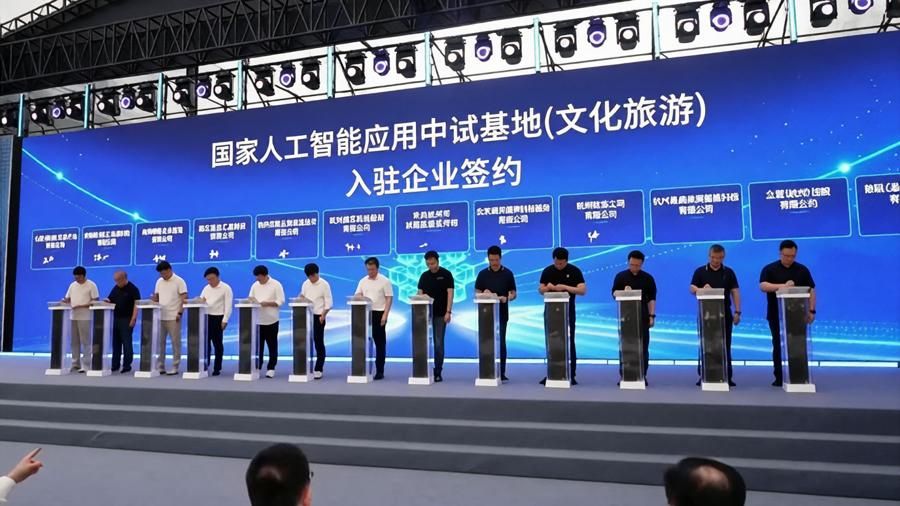
10 月 16 日,文化和旅游部办公厅公布「人工智能+文化和旅游」应用试点立项名单,14 个项目正式入列。据中新社报道,这批试点完整覆盖了今年 3 月申报通知列出的 6 个重点方向;承担单位既有文化和旅游部直属单位、共建院校,也有综合性大学与各类文旅企事业单位。
名单本身不长。但把它和 3 月那份申报通知放在一起读,会发现一个容易被略过的排序:在要求每个试点完成的四方面任务里,「数据治理」排在第一,「技术验证」排在第二。
按 2026 年 3 月《文化和旅游部办公厅关于申报「人工智能+文化和旅游」应用试点的通知》,试点包括 6 个重点方向:辅助文化艺术创作生产、提升公共文化服务水平、助力文化遗产保护传承、培育文化和旅游新业态、提升旅游服务和治理效能、加强文化和旅游市场监管。此次公布的 14 个项目,全覆盖了这 6 个方向。
据中国日报网等媒体报道,14 个项目中有 8 个集中在「培育文化和旅游新业态」与「提升旅游服务和治理效能」两个方向。从公开报道看,入列项目里既有中国国家博物馆承担的「博物馆智能服务」,也有安徽途马科技承担的「景区智能服务与管理」等,分布在文博场馆、景区、出版传媒与入境游服务等不同环节。
文化和旅游部科技教育司有关负责人介绍,这批试点将汇聚场景落地方、数据资源方、技术提供方等多方力量,推进产学研用深度融合;围绕人民可感、行业可用、管理有效的具体场景,推出一批新产品新服务。
《通知》要求每个试点选择 1 个重点方向,用 1 至 2 年时间完成四方面任务:数据治理、技术验证、场景应用、标准研制。
第一项就写得很具体:开展文化和旅游数据的采集、汇聚、加工、标注、质检和管理,探索本场景下的人工智能训练数据集建设,形成数据集不少于 1 个,数据规模原则上不小于 1TB,并推进数据集的共享和开发利用。第二项技术验证,才谈到增强通用大模型的文旅服务能力、发展文化和旅游垂直大模型、升级改造业务系统与工具软件智能终端,以及提高大模型的信息检索能力和内容生成质量。
顺序不是随意排的。没有经过采集、清洗、标注、质检的数据集,垂直大模型无从训练;没有统一的语料和口径,场景应用也很难说清「提升了多少」。需要说明的是,数据集不少于 1 个、数据规模原则上不小于 1TB 是这批试点任务的量化要求,并非面向所有文旅单位的强制门槛,但它把一件常被跳过的事摆到了台面上。
四方面任务的第三、四项,指向的是结果。场景应用要求聚焦试点方向的痛点难点,改进现有业务模式、管理方式或服务形态,形成新产品新服务,并取得显著的社会效益或经济效益;标准研制则要求在数据加工、技术应用、安全保护等环节研制标准规范和技术文件。
科技教育司有关负责人的表述是:在数据加工、技术应用、运营管理等具体环节深入探索,把好的经验做法固化成标准规范,促进复制推广。有媒体据此观察,相比以往以展示性、概念性为主的探索,这一轮的重心更偏向产业侧与治理侧,验收标尺不再是某个模型或某项技术的先进程度,而是一套服务能否在真实场景中跑通、能否被复制到别处。
这个变化对准备做 AI 的机构是一个提醒:如果一套系统只能在演示环境里工作,换个场地就要重做一遍,那它很难通过「可复制」这一关。
把政策语言降一层,六个方向说的其实是六种日常问题。
提升公共文化服务水平,对应的是知识问答、讲解引导、供需监测与精准推送;助力文化遗产保护传承,对应文物价值挖掘、非遗项目与传承人信息的记录分析;培育新业态,对应创意设计、智能终端与沉浸式体验;提升旅游服务和治理效能,对应精准推荐、行程规划、智能票务、智能讲解、自动翻译、智能客服,以及客流疏导与应急处置;加强市场监管,对应非现场监管、问题线索的智能发现与全过程可溯。
这些场景看起来差别很大,前置条件却高度一致:先有一份说得清、查得到、能追源的资料底稿。
对没有进入名单的场馆、景区和文旅企业,这份名单的参考价值不在于「羡慕 14 个名额」,而在于那套任务顺序可以照搬。
第一件是数据清点:讲解词、展陈大纲、非遗档案、票务规则、投诉与咨询记录,这些内容往往同时存在于纸质台账、个人电脑和群聊里,先统一到一个可检索、可标注的底稿上。
第二件是场景排序:选一个每周被反复问起、答案又相对稳定的问题先做——开闭馆时间、票务退改规则、路线推荐,都比一上来做「全能导游」更容易验收。
第三件是边界与留痕:哪些数据不出内网,讲解或回答出错由谁复核,日志保留多久。这三件事定在前面,后面换模型、加功能都不至于推倒重来。
政策给的是 14 个试点的名单,真正要复制的,是名单背后那套「先治理数据、再验证技术、最后固化成标准」的顺序。
信息来源与说明:本文据文化和旅游部办公厅 2026 年 10 月 16 日公布的「人工智能+文化和旅游」应用试点立项名单相关公开报道(中新社 10 月 16 日电,记者应妮;人民日报海外版、光明网、中国日报网等)及 2026 年 3 月《文化和旅游部办公厅关于申报「人工智能+文化和旅游」应用试点的通知》内容整理。文中「数据集不少于 1 个、数据规模原则上不小于 1TB」为试点任务的量化要求,不构成对全行业的强制标准;「8 个项目集中在两个方向」为媒体统计口径。瀚钦未参与上述试点及政策制定,文中不涉及公司客户案例或合作背书,也不构成政策解读或投资建议。
2026 年 10 月 16 日,文化和旅游部办公厅公布「人工智能+文化和旅游」应用试点立项名单,共 14 个项目,完整覆盖今年 3 月申报通知列出的 6 个重点方向(辅助文化艺术创作生产、提升公共文化服务水平、助力文化遗产保护传承、培育文化和旅游新业态、提升旅游服务和治理效能、加强文化和旅游市场监管)。承担单位涵盖文化和旅游部直属单位、共建院校、综合性大学及各类文旅企事业单位。
不是。这是这批试点任务中「数据治理」一项的量化要求:形成数据集不少于 1 个,数据规模原则上不小于 1TB,并推进数据集共享和开发利用。它对申报试点的主体有约束力,并非面向全行业的强制标准。不过它反映的取向值得所有机构参考——先有可用的数据集,才谈得上垂直模型与场景验证。
可以照搬那套任务顺序:先做数据清点,把讲解词、展陈大纲、非遗档案、票务规则、咨询与投诉记录统一到可检索、可标注的底稿;再做场景排序,选一个每周被反复问、答案又相对稳定的问题先跑通;最后定边界与留痕,明确哪些数据不出内网、出错由谁复核、日志留多久。顺序定对了,后面换模型、加功能都不必推倒重来。可参考我们的 AI 部署方案与免费诊断入口。