· 瀚钦(丹东)智能科技有限公司
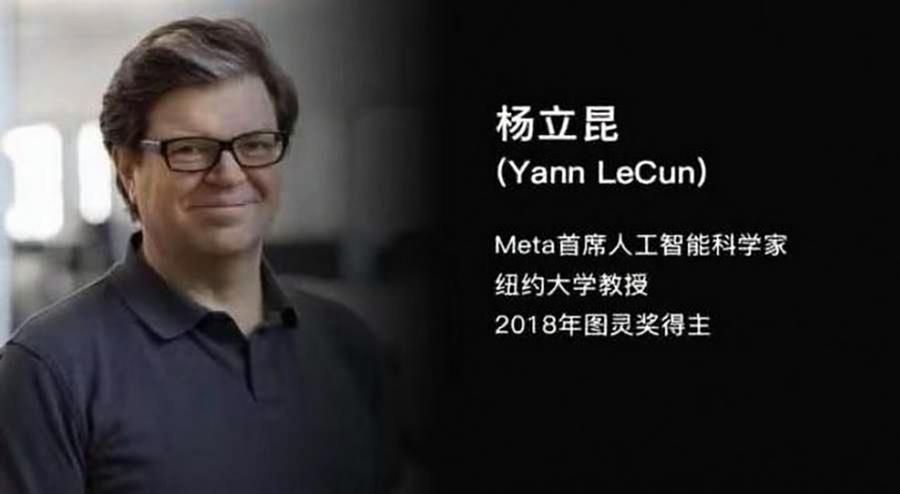
人工智能先驱人物、AMI Labs 创始人兼董事长杨立昆(Yann LeCun)在首尔表示,AI 的下一次突破不会来自大语言模型,而是来自能够理解、预测物理世界的系统——他认为,“世界模型”将推动 AI 进入下一阶段。
这句话在技术圈引发了不少讨论,但对正在做 AI 预算规划的企业来说,真正要回答的问题很朴素:那我今年这笔钱,还该不该投在大语言模型上?
杨立昆强调,为日常生活场景打造的大语言模型,在理解现实世界方面存在明显局限。他给出的例证很直观:
他由此表示:“这说明 AI 在理解语言和理解现实世界之间存在巨大差距。事实证明,机器想要读懂语言很容易,而理解现实世界并不容易。”
从原理上看也说得通:大语言模型(LLM)是根据海量训练数据学到的模式,预测下一个最可能出现的词语来生成文本。这种方法在编程、数学等涉及可预测序列的任务中表现出色,可现实世界的大多数信息,远没有语言那么容易预测。
因此他主张开发世界模型,使 AI 能够学习支配现实世界的物理规律和因果关系,让系统预测行动可能产生的结果,并与周围环境交互。
公开资料显示,杨立昆是卷积神经网络的重要发明者之一,他的理论极大推动了现代计算机视觉发展,广泛应用于图像和视觉识别,并曾在 2018 年获得图灵奖。
很多企业看到这类观点,容易得出两个极端结论:要么觉得“AI 都是泡沫,再等等”,要么觉得“既然 LLM 不行,那就赶紧上世界模型”。两种都跑偏了。
杨立昆讲的是能力边界,不是技术无用。LLM 的强项恰恰覆盖了企业当下最痛的一大块工作——处理语言和文档:
换句话说,如果你的业务环节主要是“读文档、写文字、查制度、对数据”,今天的大模型已经足够好用;如果业务要求“看懂现场、动手操作”,那确实还没到成熟期,自研更是九死一生。
这套分配的逻辑很简单:把钱花在模型已经证明擅长的能力上,而不是押注尚未成熟的方向。
杨立昆谈的是模型能力,但企业落地时还有一条更现实的约束——数据能不能放心交出去。知识库、合同、票据、客户资料,往往包含商业机密。
瀚钦的做法是把模型和知识库都部署在企业自己的服务器上:标准验证环境为 1 台服务器 + 5 个客户端 + 5 个部门账号,运行开源模型(如 qwen2.5 7B)加本地知识库,数据不出内网,验证周期通常 2–4 周。先在这一层把“文档与知识”场景跑通,收益确定、风险可控。
杨立昆说下一次突破在世界模型,这句话很可能是对的;但对绝大多数企业来说,当下能创造利润的,仍然是语言与文档层面的效率提升。不必等技术革命,也别把语言能力当成万能的“智能”——分清哪些场景今天就能做、哪些要等,才是负责任的 AI 投资方式。
大语言模型通过预测下一个词生成文本,擅长编程、数学等可预测序列任务;世界模型则试图学习支配现实世界的物理规律和因果关系,让 AI 能预测行动结果并与环境交互。杨立昆认为后者才是 AI 的下一阶段突破方向。
要,但要选对场景。LLM 在处理语言与文档类任务上已经足够成熟——内部答疑、制度检索、票据提取、文书起草、知识库问答都属于它的强项。需要理解物理世界并实时决策的场景(机器人操作、自动驾驶)才属于尚未成熟的领域。
把模型与知识库部署在企业内网服务器上做私有化部署,数据不出内网。瀚钦的标准 POC 环境为 1 台服务器 + 5 个客户端 + 5 个部门账号,运行 qwen2.5 7B 这类开源模型加本地知识库,2–4 周即可用真实业务数据验证效果。