· 瀚钦(丹东)智能科技有限公司
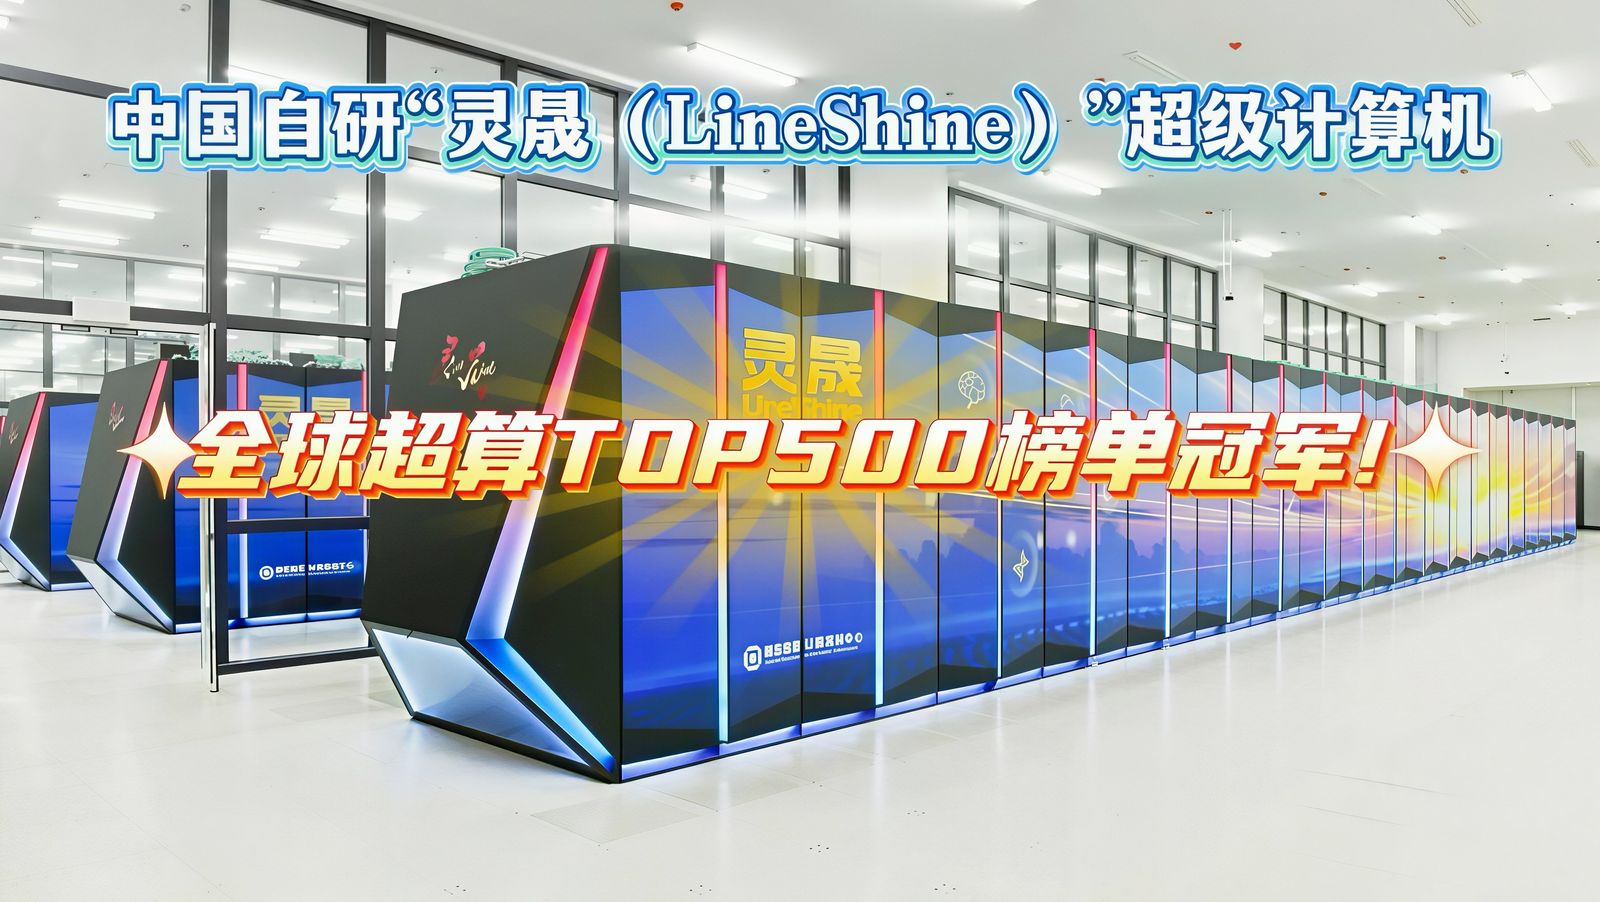
结论先行:当地时间 11 月 17 日(SC26 国际超算大会期间),新一期全球超算 TOP500 榜单发布:国家超级计算深圳中心「灵晟」E 级超算以 2.198EFlops 的 Linpack 实测性能蝉联世界第一(TOP500 官方发布口径),领先第二名约 21%,同时以 22PFlops 继续保持 HPCG 榜首。超算离中小企业很远,但这份榜单里藏着一个几乎所有企业都用得上的选型方法——它同时给了两个成绩,恰恰因为「峰值」和「实战」是两回事。
| 榜单 | 灵晟成绩 | 它测的是什么 |
|---|---|---|
| TOP500(Linpack) | 2.198EFlops,蝉联第一,领先约 21% | 理论峰值下的极限算力——机器「最高能跑多快」 |
| HPCG | 22PFlops,保持第一 | 真实科研负载下的实际表现——机器「日常干活多快」 |
两个数字差了两个数量级。这不是「灵晟」的问题,而是所有超算的共性:Linpack 跑的是规整的矩阵运算,接近芯片的理论上限;HPCG 模拟的是真实应用里最常见的稀疏计算,数据访问模式凌乱、通信频繁,成绩通常只有 Linpack 的百分之几。榜单把两个都放着,就是在提醒所有买方:峰值是参数表,实战才是产能。
把「Linpack vs HPCG」的差别翻译到企业选 AI 的场景,坑一模一样:厂商演示里问答流畅、生成漂亮——那是「参数表」;换成你的业务数据,客服机器人答不上自家退换货政策、知识库检索错漏百出——那才是你的「HPCG」。我们写过「AI 验证税」:上线前必须用真实业务数据测一轮,测的就是这个差距。测量方法可以直接抄超算榜单的思路——别问「你有多快」,问「干我的活有多快」:拿 50 条真实的客户提问、10 份真实的报表、3 个真实的工艺场景,让候选系统现场跑,对比人工基准的耗时和差错率。数字不好看的系统,参数再漂亮也该出局。
对企业更实际的,是这条新闻的产业含义。全栈自主可控 + 220 余款领域应用适配,说明国产高端算力已经从「能用」走到「生态成型」;而顶端算力每前进一级,成熟的技术和产能就会向下一层溢出——机房建设经验下沉、软件栈易用性提高、推理服务价格继续走低。这正是我们写算力主题时反复强调的判断:中小企业不需要追峰值算力,用得起的推理算力才是跟你有关的那个数字。落到具体动作上:AI 应用的算力门槛正在从「买不起」变成「按月租得起、甚至一台内网服务器跑得动」,私有化部署一个 7B 级模型加行业知识库,已经是中小企业预算内的配置——今天登顶的 E 级机器和你的办公室之间,隔着的只是一条正在快速变短的降价曲线。
给企业留一个动作:如果你正在选型或已上线 AI,把「实测成绩单」做出来——选三个真实业务场景,各跑一轮,记录耗时、差错、返工,和人工流程放在一起。这张表不仅帮你选型,也是日后向管理层证明 AI 价值的唯一硬通货。
延伸阅读:国产算力与有效计算(供给端判断)· 五大核心资源里中小企业唯一能攒的是数据(算力之外的位次)· 柴油发电机订单排到 2027(算力需求的溢出形态)· AI 验证税(实测的成本逻辑)
直接关系不大——E 级超算是国家科研基建,中小企业不会去用。但间接关系实在:顶端算力「全栈自主可控 + 应用生态成型」,意味着机房经验、软件栈、推理服务价格都在向下溢出,企业用得起的算力门槛正在快速降低。私有化部署一个中等规模模型加知识库,如今已是中小企业预算内的配置,这条降价曲线的源头就是这类新闻。
Linpack 测的是规整矩阵运算下的极限算力,接近理论上限,是「峰值」;HPCG 模拟真实科研负载里最常见的稀疏计算,成绩通常只有 Linpack 的百分之几,是「实战」。两个都公开,等于官方承认:参数表成绩和实际干活成绩是两回事。这个差别在采购任何算力或 AI 产品时都成立——看实测,不看峰值。
抄榜单的思路:用真实负载测。选三个真实业务场景(比如 50 条客户提问、10 份实际报表、3 个工艺场景),让候选系统现场处理,记录耗时、差错率、返工量,与现有的人工流程对比。测试数据必须是自己脱敏后的业务数据,不是厂商准备的示例——demo 环境的漂亮回答相当于 Linpack,你的业务数据才是 HPCG。这张实测表既是选型依据,也是向管理层证明 AI 价值的硬通货。