· 瀚钦(丹东)智能科技有限公司
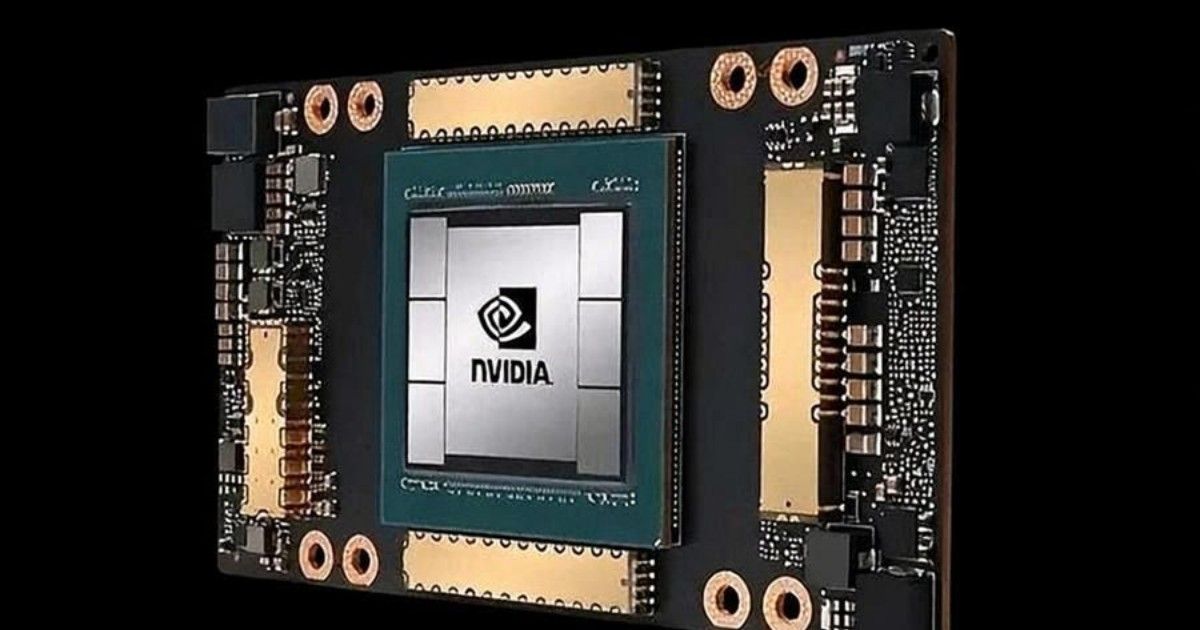
结论先行:SC26 上英伟达发布了专为科学计算优化的 Rubin HPC GPU(5 万+ CUDA 核心,2028 上市),但整场发布里最该被企业记住的不是这块卡,而是一组软件数字:同样的观测数据,算法换一版,黑洞分析从「一个多月」压到 8 分钟;同一套分子模拟软件,换 GPU 内核后快 3 倍;量子化学计算快 22 倍、成本降 75%(均为厂商公布基准与案例口径)。翻译成一句话:在你伸手买硬件之前,手里的软件和算法可能还压着几十倍的空间。
先看这组「软件提速」清单(厂商公布口径,数字为特定场景基准,非通用承诺):
| 场景 | 提速 | 靠什么 |
|---|---|---|
| 射电天文(黑洞观测数据处理) | 一个多月 → 8 分钟 | cuPhoton.xBeam 用 GPU 做数据关联处理 |
| 量子化学(VASP 计算) | 最高 22 倍,成本最高降 75% | Daviator 批量 GPU 内核 |
| 分子模拟 | 最高 3 倍,稳定性与精度改善 | cuPotential |
| 空间生物学细胞计算 | 最高 900 倍(癌症中心案例) | cuSpa(开源) |
| 单细胞数据分析 | 200 倍 | rapids-singlecell |
| 量子纠错解码 | 最高 1.3 万倍 | TCBP-JOBS 算法 |
黑洞那组数字最能说明问题:事件视界望远镜的观测会产生 PB 级数据,过去处理要数月,新算法把分析压到 8 分钟——硬件没换,换的是「怎么算」。英伟达这场发布自己也讲得很直白:科学计算不是核心越多越好,数据读取、稀疏矩阵、模板计算这些「套路」如果没有针对性优化,核心只能等数据、空转。
企业上 AI 踩的坑几乎一模一样:模型效果不理想,第一反应是「算力不够,得加卡」。但多数时候瓶颈在别处——知识库没整理干净、检索策略没调、提示词和流程没沉淀、数据格式七零八落。这些都属于「软件层」,改一遍的成本远低于加一台服务器,收益却常常是几十倍。正确顺序是:先把软件和数据榨到极限,再判断是否需要加硬件。这也是我们写灵晟超算那篇时的同款逻辑——那篇说「峰值不等于实战」,这篇补上后半句:实战成绩里,软件占的比重比硬件大得多。
Rubin HPC 的设计重点值得企业侧记一笔:为了科学计算专门加入稀疏数据加速、提升互连带宽(第七代 NVLink),因为「单纯增加计算核心并不足够,还要同步提高数据传输和处理能力,避免计算核心因等待数据而闲置」。数据中心层面的教训同样惨痛——万台级 GPU 集群里,一次网络故障能让数千颗 GPU 一起干等。
换算到企业:买了再好的模型和服务器,如果业务数据散在十几个 Excel、几个微信群、员工各自电脑里,AI 每次调用都要现找现拼,那就是「核心等数据」。算力是租来的、模型是现成的,唯一要自己动手的就是把数据理顺——这正好是我们反复讲私有知识库的原因:不是为了多先进,是为了让每一次调用都不用重新找资料。
发布会还有一个象征性节点:CUDA 发布 20 周年,全球超过 1100 万开发者、CUDA-X 超过 1000 个库。二十年前它只是一个让研究者用熟悉方式调用 GPU 的编程平台,如今成了整个加速计算生态的地基——AlphaFold 2 这类诺奖级成果也建在它上面。竞争对手可以造出参数更高的芯片,但造不出 1100 万人的使用习惯,这是二十年一天一天攒出来的复利。
企业版翻译很直接:你在 AI 上真正的资产,不是买了哪个模型(随时可换、越来越便宜),而是你自己攒下的东西——沉淀了公司口径的知识库、调教过的流程模板、每个岗位积累的 Skill、员工「遇事先问 AI 再核一遍」的习惯。这些攒得越久越难被替代,也正是我们在写律师案例时说的「第五个项目两小时」的真相。工具会平权,习惯不会。
给企业一个本月就能做的动作:挑一个已经在用 AI 的岗位,把它一个月里问过的问题、改过的稿、纠正过的错误整理成一份清单,补进知识库并写进流程模板。这一步不花一分钱,但它是你自己 CUDA 的第一行代码。
延伸阅读:灵晟超算双榜第一(峰值 vs 实测的姊妹篇)· 国产算力与有效计算(供给端判断)· 唯一能攒的是数据(数据资产的位次)· AI 验证税(实测的成本逻辑)
用不上那个具体工具(那是射电天文专用库),但要用上它揭示的规律:同一批数据、同一台硬件,换一套算法或处理流程,耗时可能差几十到上千倍。企业里的对应版本很朴素——把知识库整理好、检索策略调对、提示词和流程沉淀成模板,往往能让 AI 的可用性提升一个档,成本远低于加服务器。厂商公布的倍数均为特定场景基准,不能当作通用承诺。
先优化,再评估。顺序建议:①数据整理(业务资料结构化入库)②流程沉淀(把重复任务写成模板/Skill)③检索与提示调优 ④实测跑一轮看瓶颈在哪 ⑤确认是算力瓶颈再花钱。多数中小企业卡在第①②③步,加卡解决不了;而这一步的成本主要是人力和时间,不需要采购预算。
启发是「护城河来自习惯而非参数」。模型和工具正在快速平权——谁都调得起、价格还在跌;但企业自己攒的东西不平权:沉淀了公司口径的知识库、调教过的流程、每个岗位的 Skill、员工「先问 AI 再核一遍」的习惯,这些需要时间积累,攒得越久越难被替代。竞争对手可以买同样的模型,买不到你三年的使用积累。